Est-ce que les détecteurs d’IA sont fiables ? Depuis que ChatGPT a littéralement explosé fin 2022 et que des outils comme Gemini de Google ont suivi dans la foulée, cette question est devenue obsessionnelle — dans les salles de classe, dans les rédactions, sur les plateformes d’apprentissage en ligne. Les profs veulent savoir si leurs étudiants trichent, les éditeurs veulent s’assurer que leurs contenus sont humains, les plateformes cherchent à filtrer le contenu généré automatiquement. Et face à cette demande massive, toute une industrie de détecteurs s’est montée en quelques mois, promettant de repérer le texte d’OpenAI ou d’ailleurs avec une précision quasi chirurgicale. Sauf que la réalité, elle, est beaucoup plus compliquée — et souvent bien moins rassurante que ce que ces outils veulent vous faire croire. On va regarder ça ensemble, sans filtre, avec des chiffres concrets et des cas réels : ce que ces détecteurs font vraiment, là où ils plantent, et pourquoi s’y fier aveuglément peut coûter très cher.
En bref :
- ● Les détecteurs d’IA n’identifient pas l’IA directement : ils calculent des probabilités statistiques sur les caractéristiques du texte analysé.
- ● Les taux de précision annoncés — souvent entre 90 % et 99 % — sont mesurés dans des conditions idéales de laboratoire, loin de la réalité des textes hybrides ou retravaillés.
- ● Les faux positifs — des textes humains détectés à tort comme générés par IA — sont un problème réel et documenté, particulièrement pour les locuteurs non natifs.
- ● Compilatio, Copyleaks et Originality.ai sont les outils les plus déployés dans les contextes académiques et professionnels en 2025.
- ● Aucun détecteur ne fait l’unanimité : les résultats varient fortement d’un outil à l’autre sur un même texte soumis simultanément.
- ● Utiliser ces outils comme seule preuve dans une procédure disciplinaire est contesté par de nombreux chercheurs et associations académiques.
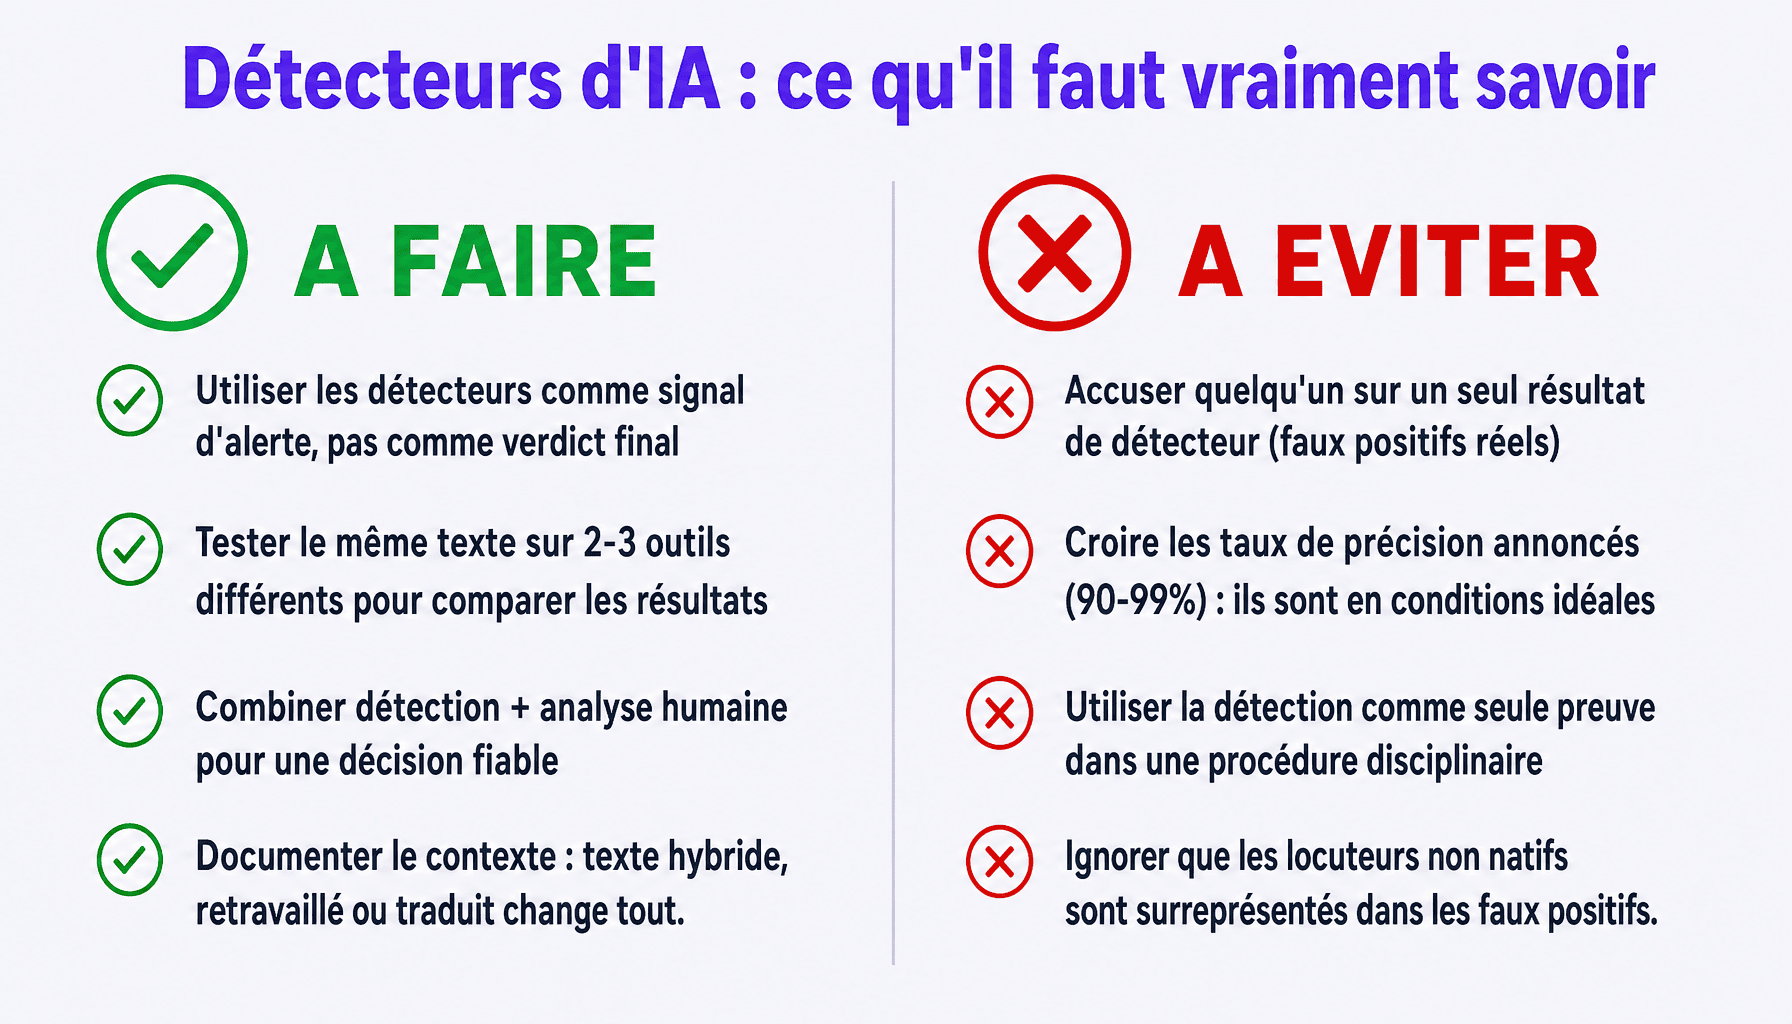
- ● Ces détecteurs restent utiles comme signal d’alerte, mais ne peuvent en aucun cas constituer un verdict définitif sur l’origine d’un contenu.
Comment fonctionnent les détecteurs d’IA, concrètement ?
Pour comprendre ce que fait réellement un détecteur d’IA, il faut d’abord oublier l’image du scanner magique qui « voit » si un texte vient de ChatGPT ou d’un humain. Ce n’est pas du tout comme ça que ça marche. Ces outils analysent des signaux statistiques — des patterns invisibles à l’œil nu — pour calculer une probabilité. Deux concepts sont au cœur de cette mécanique.
Le premier, c’est la perplexité. Imaginez un correcteur très expérimenté capable de prédire le mot suivant dans une phrase. Un texte généré par ChatGPT ou Gemini va lui sembler extrêmement prévisible : les mots s’enchaînent de façon fluide, logique, presque trop parfaite. C’est comme si quelqu’un récitait un texte appris par cœur, mot pour mot. À l’inverse, un texte humain improvise, hésite, bifurque. Il est moins prévisible — sa perplexité est donc plus élevée. Un texte IA présente une faible perplexité, un texte humain une perplexité plus haute. Simple en théorie.
Le second concept, c’est la burstiness. Les humains écrivent de façon irrégulière : une phrase courte. Puis une autre, beaucoup plus longue, avec des subordonnées, des parenthèses, des digressions. Puis encore une courte. Les modèles comme ceux d’OpenAI ou Gemini tendent à produire des phrases plus uniformes en longueur, avec un rythme régulier et lisse. Les détecteurs mesurent cette variation — ou son absence — pour affiner leur score.
| Caractéristique | Texte IA (faible perplexité) | Texte humain (perplexité élevée) |
|---|---|---|
| Prévisibilité des mots | Très élevée | Variable, imprévisible |
| Longueur des phrases | Uniforme, régulière | Très variable (burstiness) |
| Exemple concret | « Il convient de noter que… » | Phrases courtes. Puis longues. Puis un mot. |
| Score de détection | Élevé (signalé comme IA) | Faible (signalé comme humain) |
Ces détecteurs ont été entraînés sur des millions de textes — à la fois humains et générés par GPT-3, GPT-4 ou Gemini. Le problème fondamental : les modèles d’IA évoluent en permanence. Ce qui crée un décalage structurel entre l’entraînement du détecteur et les nouvelles versions des modèles. Les taux de précision annoncés varient de 78 % à 99 % selon les outils et les conditions de test. Un écart qui n’est pas anodin.
Est-ce que les détecteurs d’IA sont fiables ? La réalité des chiffres vs les promesses marketing
C’est là que ça devient vraiment intéressant — et un peu inconfortable. Les fournisseurs d’outils de détection affichent des chiffres impressionnants. Originality.ai annonce une précision de 99 %. Copyleaks revendique 99,1 %. Compilatio communique sur des taux élevés dans ses propres conditions de test. Sur le papier, c’est rassurant. Dans la vraie vie, c’est une autre histoire.
Ces mesures sont réalisées sur des benchmarks internes, dans des conditions très spécifiques : on prend un texte 100 % généré par IA, on le soumet au détecteur, il le détecte. On prend un texte 100 % humain, il ne le détecte pas. Parfait. Mais ce scénario idéal ne correspond pas à la réalité des contenus qui circulent aujourd’hui — des textes hybrides, partiellement retravaillés, paraphrasés, ou simplement corrigés à l’aide d’un outil IA.
Des tests indépendants menés par des journalistes spécialisés et des recherches académiques publiées entre 2023 et 2025 racontent une histoire très différente. Sur des textes retravaillés ou paraphrasés, les taux de vrais positifs chutent à 50–70 %. Certaines études publiées en 2023 ont montré que des détecteurs pourtant réputés tombaient à pile ou face — soit environ 50 % de précision — dès lors que le texte IA avait été passé dans un outil de paraphrase.
Et ce n’est pas tout. En juillet 2023, OpenAI a purement et simplement abandonné son propre détecteur d’IA — l’AI Classifier — en raison d’un taux de faux positifs trop élevé. Quand le créateur de ChatGPT lui-même renonce à détecter ses propres textes, le message est assez clair.
Pour résumer les données disponibles :
- Taux annoncés par les fournisseurs : 99 à 99,1 % (conditions idéales, 2023–2025)
- Taux observés sur textes retravaillés : 50 à 70 % selon les études indépendantes (2023–2024)
- Taux de faux positifs documentés : jusqu’à 25–35 % pour certains groupes spécifiques
- OpenAI a retiré son propre outil de détection en 2023 faute de fiabilité suffisante
La conclusion s’impose d’elle-même : l’écart entre le marketing et la réalité est significatif. Ce n’est pas une raison de jeter ces outils à la poubelle — mais c’est une raison sérieuse de ne pas leur accorder une confiance aveugle. Google lui-même n’a pas encore proposé de solution universelle à ce problème, et le secteur continue d’évoluer rapidement.
Faux positifs, faux négatifs : les pièges qui font vraiment mal
Derrière les statistiques globales se cachent deux types d’erreurs bien distincts — et tous les deux peuvent faire vraiment mal, selon le côté où on se trouve.
Le faux positif, c’est le scénario le plus injuste : un texte entièrement écrit par un humain est détecté comme produit par une IA. Ça arrive plus souvent qu’on ne le pense. Plusieurs profils sont particulièrement exposés :
- Les locuteurs non natifs : un étudiant qui écrit en français alors que sa langue maternelle est l’arabe ou le mandarin aura tendance à utiliser des structures plus formelles, un vocabulaire plus répétitif, des tournures plus prévisibles. Exactement ce que les détecteurs associent à l’IA.
- Les textes très techniques ou scientifiques : le vocabulaire standardisé d’un article de chimie ou de droit ressemble statistiquement à un texte IA — les termes se répètent, les structures sont codifiées.
- Les textes courts : en dessous de 200 mots, les détecteurs manquent de données statistiques suffisantes et deviennent bien moins fiables.
- Certains styles épurés : une écriture minimaliste, sobre, sans fioritures peut être interprétée comme « trop lisse » pour être humaine.
Des études ont documenté des taux de faux positifs allant jusqu’à 25–35 % pour certains groupes, notamment les non-natifs. Ce n’est pas un bug marginal — c’est un problème structurel.
Pourquoi les locuteurs non natifs sont particulièrement exposés
Un étudiant étranger qui rédige dans une langue seconde fait naturellement des choix linguistiques plus prudents, plus formels, plus uniformes. Son texte présente une faible burstiness et une perplexité réduite — non pas parce qu’il a utilisé Compilatio ou ChatGPT, mais parce qu’il maîtrise moins les nuances stylistiques de la langue cible. Le résultat : Copyleaks ou un autre outil peut le signaler comme suspect. La conséquence peut être une procédure disciplinaire injuste.
Le faux négatif, c’est l’autre face du problème : un texte généré par IA passe entre les mailles du filet. Et c’est étonnamment facile à provoquer. La paraphrase manuelle, l’utilisation d’outils de « humanizing » comme QuillBot, ou simplement retoucher quelques phrases suffisent souvent. Des tests montrent que 35 % à 50 % des textes IA retravaillés passent sans être détectés.
À noter également : les détecteurs fonctionnent mieux sur du texte brut que sur des fichiers Word ou des formats complexes. La mise en forme, les tableaux, les notes de bas de page peuvent perturber l’analyse et introduire des erreurs supplémentaires. Un détail technique qui a pourtant des conséquences très concrètes sur la fiabilité du résultat final.
Est ce que les détecteurs d’ia sont fiables — Comparatif : est-ce que Compilatio, Copyleaks et Originality.ai sont fiables en pratique ?
Passons aux choses concrètes. Quels outils existent vraiment, combien coûtent-ils, et pour qui sont-ils réellement utiles ?
| Outil | Prix | Points forts | Limites | Contexte idéal |
|---|---|---|---|---|
| Compilatio | Abonnement institutionnel (prix non public) | Multilingue, intégré Moodle, très utilisé en France | Faux positifs documentés, opacité sur les critères | Universités francophones |
| Copyleaks | À partir de ~14,95 €/mois | API disponible, multilingue, testé sur GPT-4 et Gemini | Résultats variables sur textes hybrides | Entreprises, éditeurs, plateformes e-learning |
| Originality.ai | ~29 $/mois ou paiement à la page | Très précis sur l’anglais, utilisé par les agences de contenu | Moins performant sur le français, coût élevé | Agences de contenu anglophones, SEO |
| QuillBot Detector | Gratuit (version de base) | Accessible, sans inscription | Limité en mots, orienté anglais, peu fiable seul | Test rapide, usage personnel |
Compilatio : le choix des universités francophones — mais est-il fiable ?
Compilatio est de loin l’outil le plus déployé dans l’enseignement supérieur français. Intégré directement dans des plateformes comme Moodle, il permet aux établissements de soumettre automatiquement les travaux des étudiants à une analyse combinée : détection du plagiat et détection de contenu IA. Son atout majeur est son support multilingue, ce qui le rend pertinent pour les universités francophones — là où des outils comme Originality.ai peinent sur le français.
Mais Compilatio lui-même reconnaît dans sa documentation que ses résultats doivent être interprétés avec précaution. L’outil fournit un score, pas un verdict. Le problème : dans la pratique, certains établissements utilisent ce score comme s’il était définitif. C’est là que le fossé entre l’outil et son usage devient problématique. Pour les stratégies d’adoption de l’IA dans les institutions, cette nuance est fondamentale.
Originality.ai et Copyleaks : les références du monde pro
Du côté professionnel, Originality.ai s’est imposé comme la référence des agences de contenu anglophones. Son modèle de détection a été entraîné sur des textes générés par ChatGPT, GPT-4 et Gemini, avec des mises à jour régulières. Résultat annoncé : 99 % de précision sur l’anglais. Sur le français ? Nettement moins convaincant, et les utilisateurs le confirment dans les forums spécialisés.
Copyleaks propose une approche plus polyvalente, avec une API accessible aux développeurs et une couverture multilingue plus large. À partir de 14,95 €/mois, c’est aussi l’option la plus accessible pour une utilisation professionnelle régulière. Des plateformes agentiques intègrent d’ailleurs ce type d’outils dans des workflows automatisés — ce qui montre que la détection IA s’inscrit dans un écosystème plus large.
Est-ce que les détecteurs d’IA sont fiables pour les étudiants : ce que révèle la réalité académique
Vous êtes étudiant, vous rendez un devoir, et quelques jours plus tard vous recevez un message de votre université vous signalant un taux de détection IA de 35 %. Que se passe-t-il concrètement ? C’est une situation que vivent de plus en plus d’étudiants depuis 2022, avec la généralisation de ChatGPT et l’adoption accélérée de Compilatio dans les établissements français.
En France, plusieurs centaines d’universités et grandes écoles utilisent aujourd’hui Compilatio — un chiffre en forte croissance depuis 2022. Les établissements fixent leurs propres seuils de déclenchement : certains utilisent 20 %, d’autres 25 %, parfois davantage. Ces seuils sont largement arbitraires. Qui a décidé que 20 % de contenu détecté comme IA justifie une procédure ? Aucune étude scientifique ne valide ce chiffre.
Trois problèmes concrets se posent régulièrement :
- Un étudiant étranger peut être faussement accusé à cause de son style d’écriture plus formel et répétitif dans une langue seconde — le texte est humain, mais le détecteur le signale.
- Les outils ne distinguent pas les usages : utiliser Google Docs pour corriger l’orthographe, demander à ChatGPT de reformuler une phrase maladroite, ou générer intégralement un article — tout peut produire un score similaire.
- Le seuil est binaire, la réalité ne l’est pas : un étudiant à 19 % est dans les clous, un autre à 21 % déclenche une procédure. La frontière est artificielle.
Des associations académiques et des chercheurs en sciences de l’éducation ont publiquement déconseillé d’utiliser ces outils comme seule preuve dans une procédure disciplinaire. L’International Center for Academic Integrity, entre autres, a appelé à la prudence dès 2023. En France, plusieurs juristes spécialisés dans le droit universitaire ont soulevé des questions sur la valeur probatoire de ces rapports.
La réalité, c’est que ces outils ont été conçus comme des signaux d’alerte — pas comme des juges. L’enjeu pour les universités est de former leurs équipes pédagogiques à cette nuance fondamentale, avant que des décisions injustes ne multiplient les contentieux. Le débat ne fait que commencer.
Questions fréquentes sur la fiabilité des détecteurs d’IA
Est-ce qu’un détecteur d’IA peut se tromper sur un texte écrit par un humain ?
Oui, et c’est précisément l’un des problèmes les plus sérieux. On appelle ça un faux positif : le détecteur signale un texte comme généré par une IA alors qu’il a été entièrement rédigé par un humain. Cela arrive plus souvent qu’on ne le pense — notamment avec des textes très structurés, des styles académiques formels, ou des auteurs non natifs en anglais. Certaines études montrent des taux de faux positifs pouvant dépasser 10 %, voire davantage selon les outils. Un chiffre loin d’être négligeable quand des sanctions disciplinaires sont en jeu.
Quel est le détecteur d’IA le plus fiable en français ?
Aucun outil ne fait consensus, surtout en français. La plupart des détecteurs ont été entraînés majoritairement sur des données en anglais, ce qui dégrade leurs performances sur d’autres langues. Des outils comme Copyleaks, Winston AI ou ZeroGPT proposent une détection multilingue, mais leurs résultats restent inégaux sur du contenu francophone. Si vous cherchez à savoir si les détecteurs d’IA sont fiables en français spécifiquement, la réponse honnête est : moins qu’en anglais. Croiser plusieurs outils reste la meilleure approche disponible à ce jour.
Est-ce que les détecteurs d’IA sont fiables pour détecter ChatGPT spécifiquement ?
Partiellement. ChatGPT étant le modèle le plus utilisé, les détecteurs ont davantage de données d’entraînement pour le reconnaître. Mais OpenAI améliore constamment ses modèles, et les utilisateurs apprennent à reformuler, à modifier le style ou à utiliser des outils de paraphrase pour contourner la détection. Résultat : la fiabilité se dégrade au fil du temps. Est-ce que les détecteurs d’IA sont fiables face à GPT-4o ou aux versions récentes ? Beaucoup moins qu’avec GPT-3. La course entre génération et détection est permanente, et les détecteurs accusent souvent un temps de retard.
Peut-on contourner un détecteur d’IA facilement ?
Oui, et c’est accessible à n’importe qui. Il suffit de passer un texte généré par IA dans un outil de paraphrase comme QuillBot, de demander à ChatGPT de réécrire avec un ton plus personnel, ou d’alterner manuellement quelques phrases. Ces techniques suffisent souvent à faire chuter le score de détection de manière significative. Des études indépendantes ont montré que des textes initialement détectés à 90 % d’IA pouvaient passer sous les 20 % après une simple reformulation. Cela illustre concrètement les limites structurelles de ces outils.
Les universités ont-elles le droit de sanctionner uniquement sur la base d’un détecteur d’IA ?
C’est une question épineuse. Juridiquement et éthiquement, sanctionner un étudiant sur la seule base d’un rapport automatisé est risqué — et dans de nombreux établissements, explicitement déconseillé. Le risque de faux positif est trop élevé pour que cela constitue une preuve suffisante. La plupart des chartes académiques sérieuses recommandent d’utiliser ces outils comme signal d’alerte, à compléter par une analyse humaine, un entretien ou d’autres éléments de contexte. Utiliser un détecteur comme seul et unique critère de sanction expose l’institution à des contestations légitimes de la part des étudiants.
Détecteurs d’IA en 2025 : un outil de signal, pas un tribunal
Alors, est-ce que les détecteurs d’IA sont fiables ? La réponse honnête, après avoir tout décortiqué, c’est : partiellement, dans certains contextes, et jamais seuls. Ces outils reposent sur des probabilités statistiques — pas sur une vérité absolue. Leurs taux de précision réels sont presque toujours inférieurs à ce que leurs pages marketing affichent, les faux positifs sont un problème documenté et sérieux, et aucun outil ne fait aujourd’hui consensus dans la communauté scientifique ou académique.
Ce que ça veut dire concrètement : un détecteur d’IA peut être utile comme premier signal d’alerte, pour orienter une vérification humaine ou repérer un texte qui mérite qu’on y regarde de plus près. Mais l’utiliser comme seul critère de jugement — pour sanctionner un étudiant, rejeter un contenu ou prendre une décision importante — c’est prendre un risque réel d’injustice.
Notre recommandation pratique : croisez toujours plusieurs outils, gardez un esprit critique face aux scores affichés, et intégrez systématiquement une analyse humaine dans votre processus. Ne faites jamais confiance à un pourcentage affiché sans comprendre ce qu’il mesure vraiment.
Et surtout, gardez un œil sur l’évolution de ce domaine en 2025. La course entre les générateurs d’IA et les détecteurs est loin d’être terminée — elle s’accélère. Les prochaines versions des grands modèles vont encore complexifier la donne, et les outils de détection devront s’adapter en permanence. C’est un secteur en mouvement rapide, et ce qui est vrai aujourd’hui peut être obsolète dans six mois.
Cet article est purement informatif. Il ne constitue en aucun cas un conseil juridique, disciplinaire ou académique.