Vous saviez que des robots explorent constamment le web pour découvrir les pages — des milliards de pages, chaque jour, en permanence — et que la plupart des internautes n’ont aucune idée de comment ça fonctionne vraiment ? Derrière chaque résultat affiché sur Google se cache une mécanique invisible, automatisée, qui parcourt l’intégralité d’Internet à une vitesse vertigineuse. Dans cet article, on vous explique les trois étapes clés — crawling, indexation et classement — et surtout comment les comprendre pour en tirer parti concrètement.
En bref :
- ● Des robots explorent constamment le web pour découvrir les pages : ce processus s’appelle le crawling.
- ● Ces robots (aussi appelés spiders ou crawlers) sont envoyés par les moteurs de recherche comme Google.
- ● Le crawling est la première étape avant l’indexation et le classement des pages.
- ● L’indexation (étape 2) consiste à extraire et répertorier les mots-clés dans une base de données.
- ● Un site mal configuré peut bloquer ces robots et disparaître des résultats Google.
- ● Optimiser le crawling de son site est une priorité SEO concrète et actionnable.
Des robots explorent constamment le web pour découvrir les pages. — Crawling, indexation, classement : les trois étapes que Google ne vous explique pas
Google traite plus de 8,5 milliards de recherches par jour. Derrière ce chiffre vertigineux, il y a une mécanique bien huilée que la plupart des gens ne voient jamais. Avant qu’une page apparaisse dans vos résultats, elle passe par trois grandes étapes. On vous les explique, dans l’ordre, sans jargon inutile.
| Étape | Nom | Rôle | Acteur principal |
|---|---|---|---|
| 1 | Crawling | Découverte et exploration des pages web | Googlebot, Bingbot… |
| 2 | Indexation | Extraction et classement des données dans une base | Serveurs Google, technologies type Elastic |
| 3 | Ranking | Classement des pages selon leur pertinence | Algorithmes Google (PageRank, BERT…) |
Étape 1 : des robots explorent constamment le web pour découvrir les pages
Imaginez un facteur qui parcourt toutes les rues d’une ville immense — chaque rue étant une page web, chaque panneau indicateur un lien hypertexte. Ce facteur, c’est le crawler. Il ne s’arrête jamais. Il suit chaque lien qu’il croise, note chaque adresse, et repart aussitôt vers la suivante.
Concrètement, Googlebot — le robot d’exploration de Google — visite des milliards de pages chaque jour sur Internet. Il part d’une liste d’URLs connues, suit les liens qu’il y trouve, et découvre ainsi de nouvelles pages en permanence. C’est une exploration infatigable, automatisée, à une échelle qu’aucun humain ne pourrait atteindre. Chaque lien est un panneau indicateur. Chaque page, un nouveau territoire à cartographier.
Étape 2 : l’indexation, quand les données sont classées dans une base géante
Une fois la page visitée, place à l’indexation — c’est l’étape 2. Le robot extrait les mots-clés, analyse le contenu, les images, les titres, et stocke tout ça dans une base de données colossale. Pensez à une bibliothèque : sans fiche de catalogue, un livre est introuvable. Une page non indexée, c’est exactement ça — elle existe sur le web, mais personne ne peut la trouver.
Des technologies comme Elastic sont utilisées pour gérer ce type d’indexation à grande échelle. Et l’échelle, ici, est proprement stupéfiante : l’index de Google contient aujourd’hui plus de 100 milliards de pages web. Si votre site n’y figure pas, il est invisible. Zéro trafic organique. Zéro existence aux yeux des moteurs de recherche.
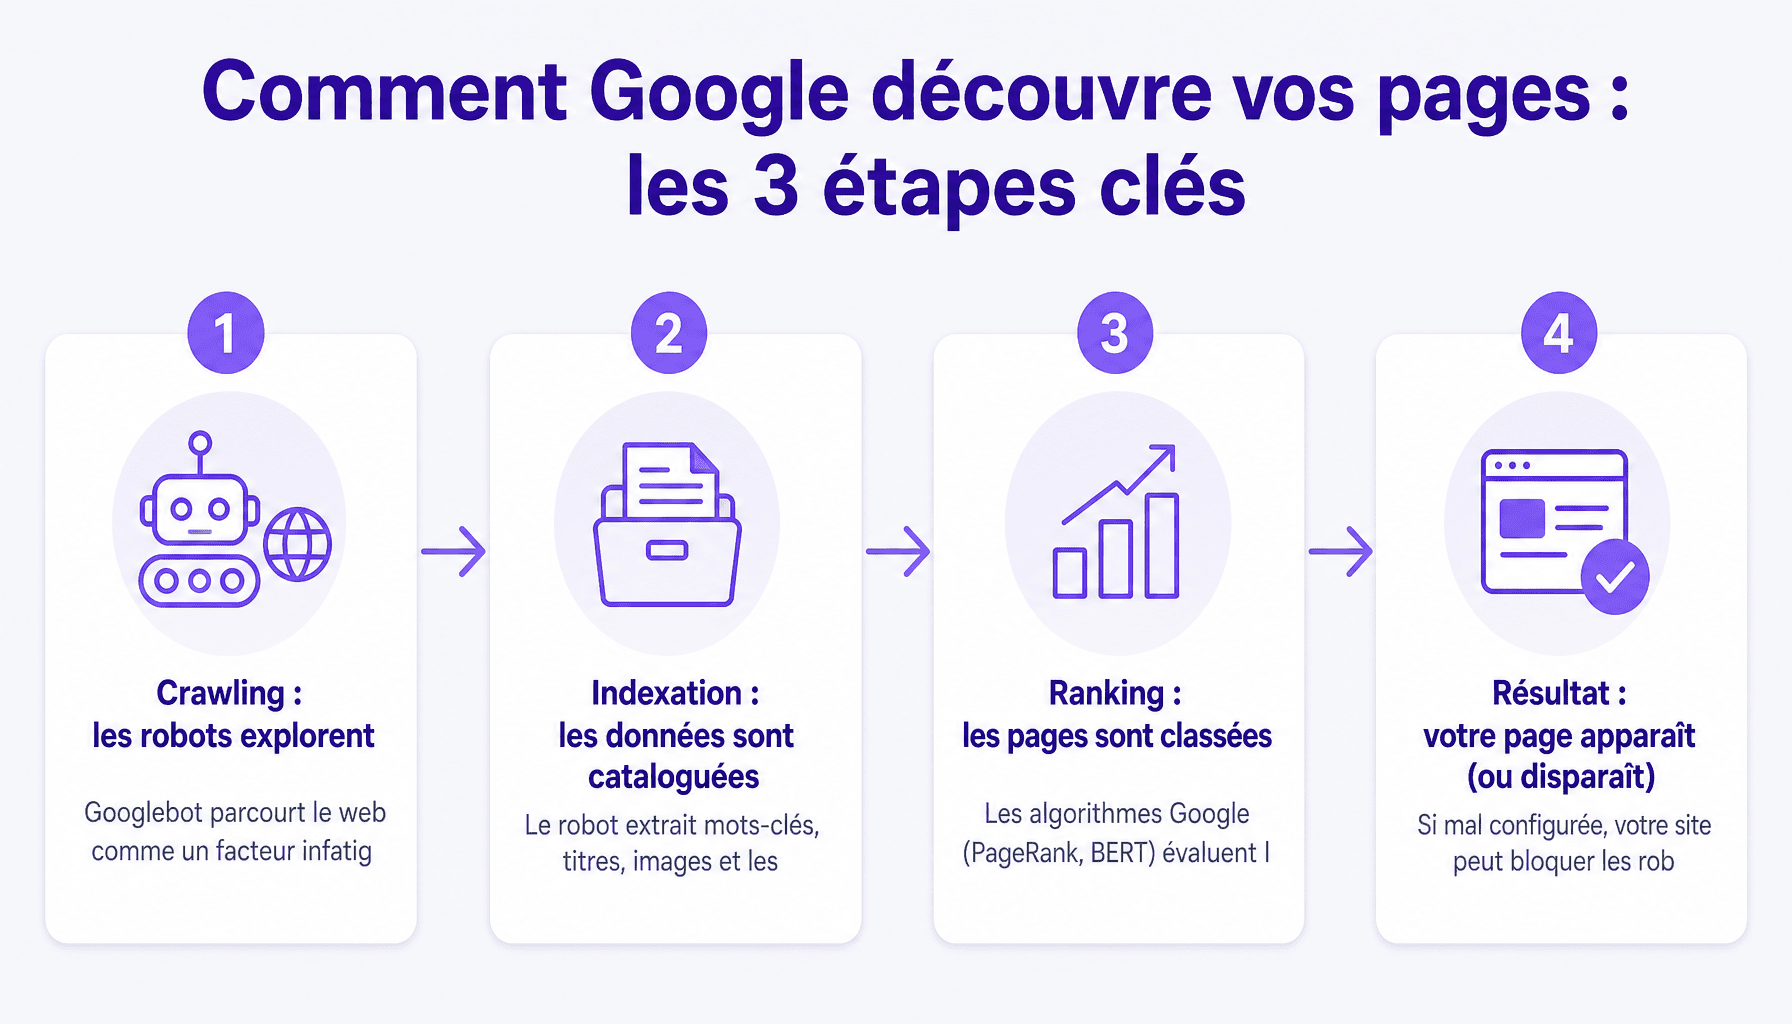
Comment des robots explorent constamment le web pour découvrir les pages et les indexer
On sait maintenant pourquoi les robots explorent le web. Voyons comment ils le font, concrètement, étape par étape. Et c’est là que ça devient fascinant.
Imaginez un stagiaire surdoué qui a lu tout Internet et qui suit méthodiquement chaque note de bas de page qu’il croise. C’est exactement ce que fait un crawler. Voici sa méthode :
- 1. Les seed URLs : le robot démarre avec une liste d’adresses connues, appelées URLs de départ. Ce sont des pages déjà répertoriées ou soumises par les propriétaires de sites.
- 2. Lecture du code HTML : il visite chaque page, analyse son code source, extrait tous les liens hypertextes présents.
- 3. File d’attente : les nouvelles URLs découvertes sont ajoutées à une file d’attente pour être visitées à leur tour. Le processus est continu.
- 4. Respect du fichier robots.txt : avant d’explorer un site, le robot consulte ce fichier qui lui indique les zones autorisées et interdites.
- 5. Crawl budget : chaque site reçoit un quota de pages explorables par période. Le robot s’y tient.
💡 Astuce — Le fichier robots.txt
Le fichier robots.txt est un simple fichier texte placé à la racine de votre site (ex. : monsite.com/robots.txt). Il indique aux robots quelles pages ils peuvent ou ne peuvent pas explorer. Mal configuré, il peut bloquer l’ensemble de votre site des résultats Google. Vérifiez-le régulièrement dans la Google Search Console.
Google utilise d’ailleurs plusieurs types de bots selon les contextes : Googlebot Desktop simule un navigateur sur ordinateur, tandis que Googlebot Smartphone simule un mobile — ce qui explique pourquoi la version mobile de votre site est aujourd’hui prioritaire pour le référencement. Pour aller plus loin sur l’évolution de ces outils, il est utile de comprendre les origines de l’intelligence artificielle qui pilote ces systèmes.
| Moteur de recherche | Nom du bot | Fréquence estimée |
|---|---|---|
| Googlebot | Quelques heures à plusieurs semaines | |
| Bing | Bingbot | Quelques jours à plusieurs semaines |
| Yandex | YandexBot | Variable selon la popularité |
| DuckDuckGo | DuckDuckBot | Moins fréquent |
Le crawl budget : pourquoi toutes vos pages ne sont pas forcément explorées
Google n’explore pas votre site à l’infini. Il alloue à chaque site un budget de crawl — un quota de pages visitables sur une période donnée. Pour les sites de moins de 1 000 pages, ce n’est généralement pas un problème. Mais pour les grands sites e-commerce ou les blogs avec des milliers d’articles, chaque page gaspillée compte.
⚠️ Attention — Pages dupliquées
Les pages dupliquées (contenu identique sur plusieurs URLs) gaspillent votre crawl budget. Google explore ces pages inutiles au détriment de vos vraies pages à indexer. Utilisez des balises canonical pour indiquer la version de référence.
Pourquoi des robots explorent constamment le web pour découvrir les pages — et ce que ça change pour votre SEO
On arrive au cœur du sujet. Comprendre que des robots explorent constamment le web pour découvrir les pages, c’est bien. Savoir ce que ça implique pour votre site, c’est ce qui fait la différence entre un site visible et un site fantôme.
La règle est brutalement simple : si un robot ne trouve pas votre page, Google ne la connaît pas. Et si Google ne la connaît pas, vos utilisateurs non plus. Vous avez 0% de chance d’apparaître dans les résultats, peu importe la qualité de votre contenu. C’est là que le crawling devient une priorité SEO absolue.
Selon certaines études, environ 30% des pages d’un site moyen ne sont jamais crawlées. Trente pour cent de contenu invisible. Pour un blog ou un site e-commerce, c’est potentiellement des dizaines de pages perdues dans le néant numérique.
Voici les leviers concrets pour optimiser l’exploration de votre site :
- Maillage interne solide : reliez vos pages entre elles avec des liens logiques. Le robot suit les liens — donnez-lui un chemin clair.
- Sitemap XML à jour : ce fichier liste toutes vos pages importantes. Il guide le robot directement vers elles.
- Fichier robots.txt bien configuré : autorisez l’accès aux pages que vous voulez indexer, bloquez ce qui est inutile (pages admin, doublons…).
- Vitesse de chargement : un robot abandonne une page trop lente. Chaque seconde compte — visez un temps de chargement inférieur à 2,5 secondes.
- Éviter les pages orphelines : une page sans aucun lien entrant est quasi-invisible pour un robot. Reliez-la à votre structure.
Google revisite les pages populaires toutes les quelques heures. Les pages moins importantes ? Toutes les semaines, voire tous les mois. Autant dire que si votre contenu est mis à jour régulièrement, il a tout intérêt à être bien crawlable. Et si vous vous intéressez aux moteurs de recherche dopés à l’IA, vous verrez que ces logiques de crawling évoluent rapidement avec les nouvelles technologies.
✅ Conseil — Soumettez votre sitemap
Dans Google Search Console, rendez-vous dans la section « Sitemaps » et soumettez l’URL de votre sitemap XML (ex. : monsite.com/sitemap.xml). C’est gratuit, rapide, et ça accélère significativement la découverte de vos nouvelles pages par les robots Google.
Les erreurs qui bloquent les robots et font disparaître vos pages des résultats
Certaines erreurs techniques sont de véritables pièges à robots. Elles peuvent faire perdre jusqu’à 80% du trafic organique d’un site. Voici les plus courantes :
- Balise noindex mal placée : si elle est présente sur une page que vous voulez référencer, Google l’ignore complètement.
- Fichier robots.txt trop restrictif : une seule ligne mal rédigée peut bloquer l’ensemble de votre site à l’exploration.
- Liens cassés (erreurs 404) : le robot tombe dans un cul-de-sac et perd du temps — votre temps de crawl.
- Redirections en chaîne : trois redirections successives ralentissent et découragent le robot.
- Contenu derrière un formulaire de connexion : inaccessible pour un robot, donc non indexé.
- JavaScript non rendu : si votre contenu est généré uniquement via JavaScript et que le robot ne peut pas l’exécuter, il voit une page vide.
Ces erreurs sont souvent invisibles à l’œil nu. Un audit technique régulier est indispensable.
Questions fréquentes sur les robots qui explorent le web
Comment s’appelle l’étape où des robots explorent constamment le web pour découvrir les pages ?
Cette étape s’appelle le crawling (ou exploration). Des robots — appelés crawlers ou spiders — explorent constamment le web pour découvrir les pages en suivant les liens hypertextes d’un site à l’autre. C’est la toute première phase du processus SEO, avant l’indexation et le classement.
Quelle est la différence entre le crawling et l’indexation ?
Le crawling, c’est la découverte : le robot visite la page. L’indexation, c’est l’enregistrement : le contenu est analysé et stocké dans la base de données de Google. Une page peut être crawlée sans être indexée — si elle est jugée de faible qualité ou bloquée par une directive noindex.
Peut-on empêcher les robots d’explorer certaines pages de son site ?
Oui, tout à fait. Deux outils principaux permettent de le faire : le fichier robots.txt, qui indique aux crawlers les zones interdites, et la balise meta noindex, qui empêche l’indexation d’une page spécifique. C’est essentiel pour protéger les pages sensibles (espace client, doublons) et optimiser le crawl budget.
À quelle fréquence les robots de Google explorent-ils le web pour découvrir les pages ?
Il n’existe pas de fréquence fixe. Des robots explorent constamment le web pour découvrir les pages, mais la cadence varie selon la popularité du site, la fréquence de mise à jour du contenu et le crawl budget alloué. Un grand site d’actualités peut être revisité toutes les quelques minutes, un petit site toutes les semaines.
Crawling et SEO : par où commencer concrètement ?
Voilà l’essentiel à retenir : derrière chaque résultat Google se cachent trois étapes bien distinctes — le crawling, l’indexation et le classement. Des robots explorent constamment le web pour découvrir les pages, et comprendre ce mécanisme, c’est vraiment la base de toute stratégie SEO sérieuse. Pas une option, une nécessité.
Le premier geste concret ? Vérifiez votre fichier robots.txt et votre sitemap XML dès aujourd’hui — vous pourriez avoir de mauvaises surprises.
Et c’est là que ça devient fascinant : avec l’IA qui s’invite dans le crawling et l’émergence des crawlers sémantiques, ce domaine évolue à toute vitesse. Restez curieux, faites vos propres recherches — le SEO de demain se construit maintenant.